· 7 min de leitura
Derrubaram nosso login sem tocar no servidor
- seguranca
- api
- backend
- systemdesign
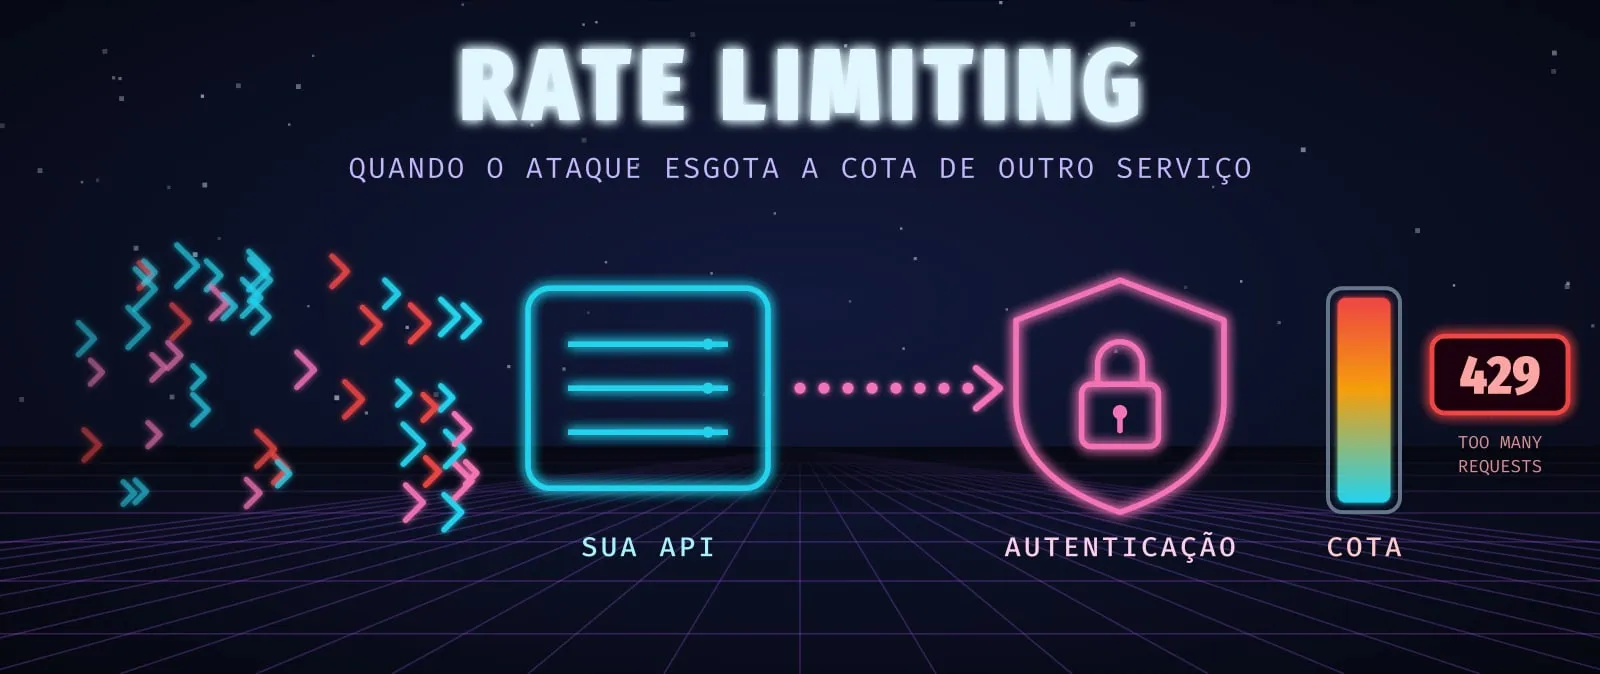
Numa empresa em que trabalhei, tínhamos um sistema de agendamento. Nada de exótico: clientes entravam, marcavam horários, recebiam confirmação. A autenticação era terceirizada para um provedor externo, que cuidava do login, do cadastro de novos usuários e da validação das sessões.
Um dia, o sistema simplesmente parou. Ninguém conseguia entrar, ninguém conseguia se cadastrar e, poucos minutos depois, quem já estava logado também foi expulso. Ficamos 4 horas fora do ar.
Nossos servidores estavam bem. CPU tranquila, banco respondendo, nenhum pico absurdo de memória. O problema estava em outro lugar: alguém tinha esgotado a cota da API do nosso provedor de autenticação. E fez isso usando a nossa própria aplicação.
O que aconteceu
O ataque mirou o endpoint de cadastro de novos usuários. Cada requisição de cadastro que chegava na nossa API gerava uma chamada ao provedor de autenticação. O atacante só precisou disparar cadastros em volume até a cota do provedor acabar.
Até aí, o estrago seria “só” o cadastro fora do ar. Mas três decisões nossas transformaram um ataque a um endpoint numa queda total:
- Não tínhamos rate limit próprio na frente do cadastro. Toda requisição que chegava era repassada ao provedor. Nós éramos, na prática, um proxy aberto para gastar a cota de um terceiro.
- Cadastro e login usavam a mesma validação no provedor. Quando a cota acabou, os dois fluxos morreram juntos.
- A sessão era revalidada no provedor a cada 30 minutos. Ou seja, mesmo quem já estava logado precisava de uma nova chamada externa. Sem cota, a revalidação falhava e o usuário caía.
O que nos salvou foi um sistema de fallback próprio com JWT que já existia. Desabilitamos o provedor de autenticação e passamos a validar os clientes pelo nosso sistema. Mas a troca foi manual, sob pressão, e levou tempo. Daí as 4 horas.
Rate limiting não protege só os seus servidores
A maioria dos conteúdos sobre rate limiting fala em proteger a sua infraestrutura: evitar que um cliente derrube seu banco ou consuma toda a sua CPU. Isso é verdade, mas é metade da história.
A OWASP classifica esse problema como API4:2023 – Unrestricted Resource Consumption, e a definição inclui explicitamente o custo de serviços de terceiros: SMS, e-mail, pagamentos, autenticação. Toda vez que uma requisição sua dispara uma chamada externa, você está gastando um recurso finito que não controla.
Se um endpoint público chama um serviço externo, o seu rate limit precisa proteger a cota desse serviço, não só o seu servidor.
Foi exatamente essa a lição. Nossos servidores aguentariam o ataque tranquilamente. A cota do provedor, não.
O que eu faria diferente (e faço hoje)
1. Rate limit próprio em todo endpoint que chama terceiros
O cadastro é o endpoint mais perigoso de qualquer sistema: é público, não exige autenticação e geralmente dispara chamadas externas (provedor de identidade, e-mail de confirmação, SMS). Ele precisa de limites em mais de uma dimensão:
- Por IP, para segurar o ataque mais simples.
- Por identificador (e-mail, telefone, dispositivo), porque ataques distribuídos trocam de IP o tempo todo.
- Um orçamento global para chamadas ao provedor, abaixo da cota real dele.
Esse último é o que quase ninguém faz. Se o provedor permite X chamadas por minuto, a sua aplicação deveria se impor um teto menor e reservar parte dele para os fluxos críticos.
Um exemplo com Node.js e a biblioteca rate-limiter-flexible:
import { RateLimiterRedis } from 'rate-limiter-flexible';

// Limite por IP no cadastro
const signupPorIp = new RateLimiterRedis({
  storeClient: redis,
  keyPrefix: 'signup_ip',
  points: 5,      // 5 cadastros
  duration: 600,  // a cada 10 minutos
});

// Orçamento global de chamadas ao provedor vindas do cadastro.
// Fica bem abaixo da cota real, para sobrar espaço para login e sessão.
const orcamentoCadastro = new RateLimiterRedis({
  storeClient: redis,
  keyPrefix: 'auth_provider_signup',
  points: 200,
  duration: 60,
});

app.post('/signup', async (req, res) => {
  try {
    await signupPorIp.consume(req.ip);
    await orcamentoCadastro.consume('global');
  } catch {
    return res.status(429).json({ erro: 'Muitas tentativas. Tente novamente em instantes.' });
  }

  // Só agora chamamos o provedor de autenticação
  // ...
});
Se o orçamento do cadastro acabar, o cadastro para, mas o login continua funcionando. É uma degradação controlada, em vez de uma queda total.
2. Isolar os fluxos (bulkhead)
O nosso maior erro de arquitetura foi deixar cadastro e login competirem pelo mesmo recurso. É o padrão bulkhead, emprestado dos navios: compartimentos separados para que um vazamento não afunde tudo.
Na prática:
- Cotas separadas (ou pelo menos reservadas) para cadastro, login e validação de sessão.
- Prioridade para quem já é cliente. Um usuário logado vale mais do que um cadastro novo no meio de um ataque.
3. Validar a sessão localmente
A revalidação a cada 30 minutos foi o que transformou um ataque ao cadastro em queda total. Se cada usuário logado depende de uma chamada externa para continuar logado, a disponibilidade do seu sistema é, no máximo, a disponibilidade do seu provedor.
A maioria dos provedores de identidade emite tokens JWT assinados e publica as chaves públicas num endpoint JWKS. Com isso, você valida a sessão localmente, sem chamar o provedor a cada requisição:
import { createRemoteJWKSet, jwtVerify } from 'jose';

// As chaves públicas ficam em cache; não há chamada ao provedor por requisição
const JWKS = createRemoteJWKSet(new URL('https://auth.exemplo.com/.well-known/jwks.json'));

export async function validarSessao(token: string) {
  const { payload } = await jwtVerify(token, JWKS, {
    issuer: 'https://auth.exemplo.com',
    audience: 'minha-api',
  });
  return payload;
}
O trade-off é a revogação: um token válido localmente continua válido até expirar, mesmo que a sessão tenha sido encerrada no provedor. Para a maioria dos sistemas, tokens de curta duração resolvem bem esse problema. Para sistemas que precisam de revogação imediata, a consulta ao provedor pode ficar restrita às operações sensíveis, e não a toda requisição.
4. Fallback automático, não heroico
Ter o fallback com JWT foi o que nos tirou do buraco. Mas ele dependia de alguém perceber o problema, entender a causa e fazer a troca na mão.
Hoje eu colocaria um circuit breaker na integração com o provedor: se a taxa de erros (especialmente respostas 429) passar de um limite, o sistema muda sozinho para o modo de contingência e avisa o time. A decisão de “virar a chave” deveria ser uma configuração, não uma reunião de crise.
E fallback que nunca foi testado é só esperança. Vale simular a falha do provedor de tempos em tempos.
5. Monitorar a cota como se fosse um recurso seu
Nós monitorávamos CPU, memória e latência. Não monitorávamos o consumo de cota do provedor. Se tivéssemos um alerta em 70% de uso, teríamos visto o ataque começar, e não só o resultado dele.
Toda dependência externa com limite deveria ter:
- Métrica de consumo de cota (muitos provedores devolvem isso nos headers de resposta).
- Alerta antes do limite, não quando ele estoura.
- Alerta para aumento de respostas 429 vindas do provedor.
6. Dificultar a automação no cadastro
Rate limit reduz o estrago, mas não diferencia um humano de um script. No cadastro, vale adicionar uma barreira contra bots (captcha ou desafio invisível) antes de qualquer chamada externa. Assim, a requisição automatizada morre na sua borda e não gasta a cota de ninguém.
Isso fica mais importante a cada mês: com agentes de IA e ferramentas de automação cada vez mais acessíveis, disparar milhares de cadastros falsos ficou trivial. A pergunta deixou de ser “se” e virou “quando”.
Checklist para APIs que dependem de terceiros
- Todo endpoint público que chama um serviço externo tem rate limit próprio.
- Os limites consideram IP e identificador (e-mail, dispositivo, chave de API).
- Existe um orçamento global abaixo da cota real de cada provedor.
- Fluxos críticos (login, sessão) têm cota reservada e não competem com cadastro.
- A sessão é validada localmente sempre que possível.
- Existe fallback para o provedor de autenticação, com troca automática e testada.
- O consumo de cota dos provedores é monitorado, com alerta antes do limite.
- O cadastro tem proteção contra automação antes de chamar qualquer serviço externo.
Conclusão
O ataque não foi sofisticado. Não houve exploração de vulnerabilidade, nem invasão, nem vazamento. Alguém só percebeu que cada cadastro nosso custava uma chamada a um serviço externo e que nós não colocávamos limite nenhum nisso.
A lição que ficou: a resiliência do seu sistema é decidida também nas dependências que você não controla. Rate limiting não é só uma ferramenta de performance. É uma decisão de arquitetura e de segurança, e precisa olhar para dentro (seus servidores) e para fora (as cotas de quem você consome).
E você? Já teve um sistema derrubado por uma dependência externa? Vamos conversar nos comentários! 🚀