· 10 min de leitura
Meu site tinha 91 visitantes. A maioria era robô (parte 1)
- observabilidade
- webperf
- cloudflare
- analytics
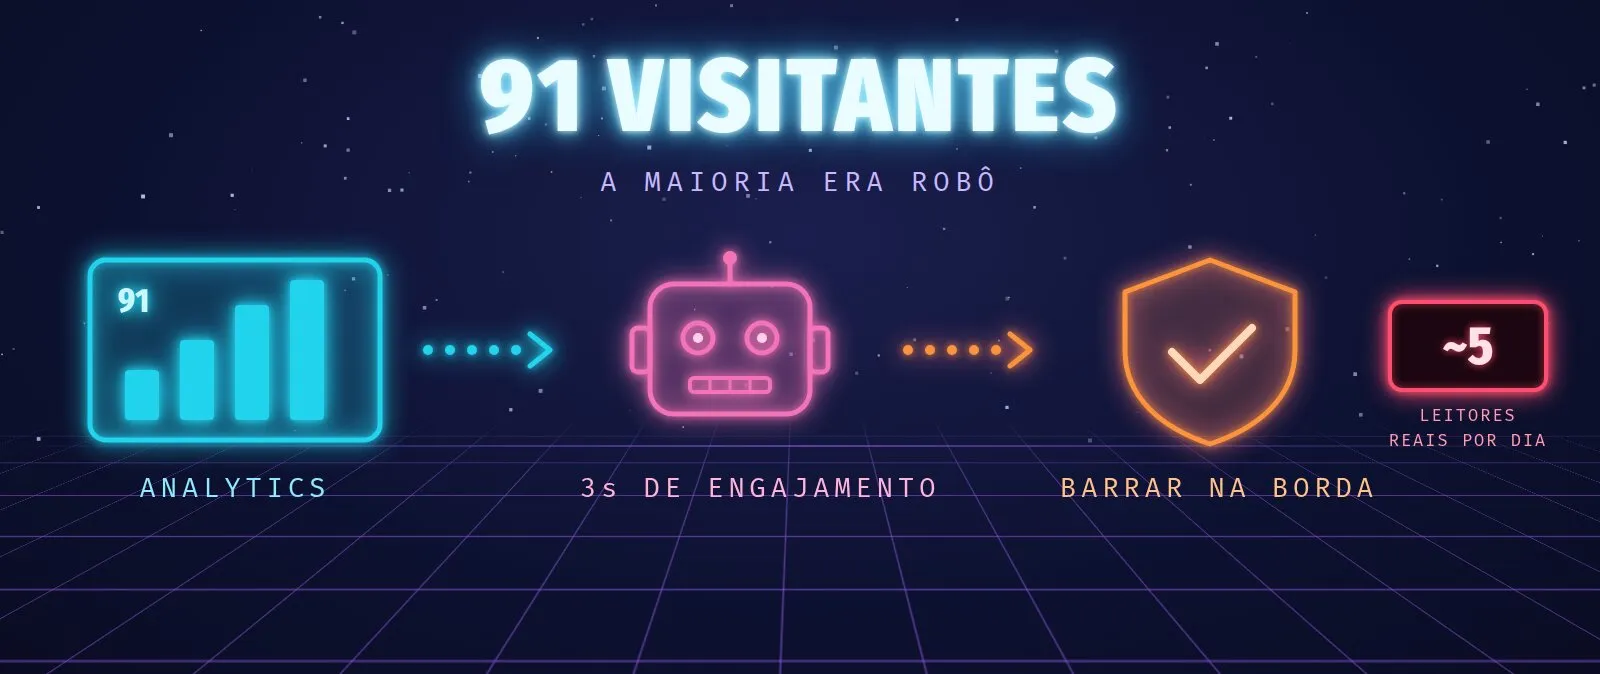
Há algumas semanas migrei meu portfólio para Astro e passei a publicar meus artigos no próprio site, e não só no dev.to. Liguei o Google Analytics, esperei alguns dias e fui olhar os números.
91 usuários em 28 dias. Para um site pessoal recém-lançado, parecia ótimo.
Aí olhei a coluna do lado: tempo médio de engajamento de 3 segundos. E 89% das sessões chegando como “Direct”, sem origem nenhuma. Ninguém lê um artigo técnico em 3 segundos.
Fui atrás de quem eram essas 91 pessoas. A maioria não era pessoa.
O contexto
O site é estático, gerado com Astro e hospedado no Cloudflare Pages, com custo zero. Cada push na main publica uma versão nova. Para acompanhar o que acontece com ele, eu tinha quatro fontes de dados:
- Google Analytics 4, com o script na página.
- Search Console, para a busca do Google.
- Analytics do domínio na Cloudflare, que vê cada requisição HTTP que passa por ela.
- Cloudflare Web Analytics, que mede visitas pelo navegador, parecido com o GA.
A pergunta que eu queria responder era simples: quantas pessoas de verdade leem o que eu escrevo?
Três ferramentas, três números diferentes
Coloquei os números lado a lado, todos coletados no mesmo dia:
| Ferramenta | Período | O que mede | Número |
|---|---|---|---|
| Cloudflare (domínio) | 24 horas | Toda requisição HTTP, inclusive de robôs | 635 requisições, 299 “visitas” |
| Cloudflare Web Analytics | 7 dias | Navegadores reais, com robôs excluídos | 33 visitas, 37 visualizações |
| Google Analytics 4 | 28 dias | Quem executa o script do GA | 91 usuários, 3s de engajamento |
| Search Console | 6 dias | Aparições na busca do Google | 7 impressões, 0 cliques |
A primeira reação é perguntar qual deles está certo. A resposta é: todos. Cada ferramenta enxerga uma camada diferente.
- A Cloudflare do domínio conta requisições. Qualquer coisa que bata no servidor entra: navegador, robô, scanner,
curl. - O GA conta quem executa JavaScript. Robôs simples ficam de fora, mas robôs que rodam um navegador de verdade entram como se fossem visitantes.
- O Web Analytics da Cloudflare também roda no navegador, mas combina isso com o que a Cloudflare sabe sobre a origem da requisição para excluir robôs.
- O Search Console só olha a busca do Google.
A pergunta certa não é “qual número é o real”, e sim “o que cada ferramenta consegue enxergar”.
Juntando tudo, a conta honesta é de algo como 5 leitores reais por dia. Bem longe dos 91 usuários da primeira impressão.
Quem eram os robôs
O analytics do domínio na Cloudflare mostrou de onde vinha o volume. Nas últimas 24 horas:
- Um único IP de Singapura, de um provedor de servidores na nuvem, fez 170 das 635 requisições. Mais de um quarto do tráfego do site, vindo de uma máquina só.
- Havia requisições para
danielcamucatto.dev.br:8080,:8443,:2053,:2087,:2096. Ninguém digita isso no navegador. É varredura automática, procurando painéis de administração e serviços expostos. - O
robots.txtfoi pedido 42 vezes.
No GA o padrão era o mesmo, só que disfarçado de “usuário”:
- 54% dos usuários vinham dos EUA, com 1 segundo de engajamento médio.
- Reino Unido, Polônia, França e Índia: 0 segundo.
- E o Brasil, de onde vem quem de fato me lê? 5 usuários, com 53 segundos de engajamento médio.
Nem todo robô é ruim. O Googlebot aparece porque está indexando o site, e o LinkedInBot porque gera a prévia quando alguém compartilha um link. Esses eu quero que continuem passando.
Por que o Google Analytics não resolve
Minha primeira ideia foi filtrar esses robôs no próprio GA. Não dá.
- O GA4 já exclui automaticamente os robôs conhecidos. Os que sobram nos relatórios são justamente os que ele não reconhece.
- Os filtros de dados do GA4 servem só para dois casos: tráfego interno e tráfego de desenvolvedor. Não existe um filtro de “robô desconhecido”.
- Dá para montar uma análise mostrando só sessões engajadas. Mas isso muda o que eu vejo, não o que é coletado. Os robôs continuam lá, inflando todo o resto.
A conclusão foi que o relatório é o lugar errado para separar robô de gente. O lugar certo é antes de a requisição chegar ao site.
A decisão: barrar na borda
Como o domínio já passa pela Cloudflare, liguei o Bot Fight Mode. Ele desafia tráfego automatizado antes de chegar ao site e deixa passar os robôs verificados, como o Googlebot e o LinkedInBot.
Não é de graça:
- Ferramentas legítimas podem ser bloqueadas, como verificadores de links ou um
curlde monitoramento. Se algum serviço meu parar de acessar o site, é o primeiro lugar para olhar. - No plano gratuito, não dá para fazer regras finas. É ligar ou desligar, para o domínio inteiro.
Para um site pessoal, a troca vale a pena. Para um e-commerce com integrações de parceiros, eu pensaria duas vezes e iria para regras específicas.
Se funcionou? Liguei no mesmo dia em que escrevi este texto. Os números de antes e depois ficam para a parte 2.
Medir antes de otimizar
Com os robôs identificados, olhei a outra coisa que o Web Analytics da Cloudflare entrega: Core Web Vitals de usuários reais, e não de um teste de laboratório.
O retrato geral era bom:
- LCP (tempo até o maior elemento aparecer) bom em 81% das visitas.
- INP (tempo de resposta a cliques) bom em 83%.
- CLS (quanto o layout “pula” durante o carregamento) bom em 94%.
Mas tinha dois pontos fora da curva.
1. A capa que pesava mais que o artigo
Um artigo teve LCP de 2,7 segundos, e o elemento responsável era a capa: um JPG de 1600 px com cerca de 110 KB, entregue igual para desktop e celular.
Passei as capas para o componente <Image> do Astro, que gera versões em WebP em vários tamanhos e deixa o navegador escolher a certa:
<Image
  src={coverLocal}
  alt=""
  widths={[400, 768, 1200, 1536]}
  sizes="(min-width: 816px) 768px, calc(100vw - 48px)"
  class="mt-8 w-full h-auto rounded-lg"
  priority
/>
No celular, a capa caiu de cerca de 110 KB para 21 KB. No desktop, para cerca de 50 KB. O priority faz o navegador buscar essa imagem antes das outras, porque ela é a primeira coisa que aparece na tela.
2. O texto que pulava
As capas dos artigos antigos, importados do dev.to, vinham sem width e height. Sem essas dimensões, o navegador não sabe quanto espaço reservar. O texto aparece, a imagem carrega e empurra tudo para baixo.
A correção foi pequena: ler as dimensões da própria URL do CDN do dev.to e colocá-las na tag. Para confirmar, medi com um script no Chromium headless, simulando rede lenta e CPU seis vezes mais lenta. No artigo do Redis, o CLS no desktop caiu de 0,0697 para 0,0000.
3. O caso em que eu não mexi
O Web Analytics também mostrava um CLS de 0,43 na home, bem acima do limite de 0,1. Parecia grave.
Tentei reproduzir em 11 combinações: desktop, tablet e celular, tema claro e escuro, rede e CPU lentas, e até um tema salvo diferente do tema do sistema. Deu 0 em todas.
Olhando de novo o dado, era uma única visita. Provavelmente alguém rolando a página antes de ela terminar de carregar, ou redimensionando a janela.
Mexer no layout da home sem conseguir reproduzir o problema seria chute. E chute em front-end costuma criar o problema que você queria evitar. Decisão técnica também é saber quando não mexer. Se o padrão aparecer de novo com mais visitas, eu volto nele.
O outro lado: distribuição
Com cerca de 5 leitores reais por dia, ficou claro que o site sozinho não traz ninguém. Quem traz gente é o LinkedIn. Então fui olhar os números de lá com o mesmo cuidado.
O post de divulgação do meu último artigo, sobre rate limiting, teve 123 impressões e nenhuma reação. Texto longo, bem estruturado, com um link para o meu site no meio.
Comparando com o meu próprio histórico:
| Tipo de post | Impressões |
|---|---|
| Relato pessoal, sem link | 1.934 |
| Artigo publicado dentro do LinkedIn | 380 a 520 |
| Texto com link para fora do LinkedIn | 123 |
É muito comum o LinkedIn entregar menos posts que levam o usuário para fora da plataforma. A empresa não confirma isso oficialmente, mas os meus números apontam na mesma direção.
Então mudei duas coisas:
- O post do artigo seguinte saiu com o link no primeiro comentário, e não no corpo do texto.
- Este artigo está sendo publicado inteiro dentro do LinkedIn, além do site.
No caminho, uma descoberta prática: editar um post agendado no LinkedIn muda o texto, mas mantém a prévia do link. Eu tirei o link, salvei, e o cartão com a imagem e o domínio continuava lá. A única saída foi recriar o post do zero e excluir o antigo.
Como foi trabalhar com um agente de IA
Boa parte desse trabalho eu fiz junto com um agente de IA (o Claude Code), no terminal e no navegador. Ele abriu os painéis do GA, do Search Console, da Cloudflare e do LinkedIn, comparou os números, escreveu o script que mediu o CLS, otimizou as capas e abriu os PRs.
Algumas coisas me chamaram a atenção:
- Ele parou nos lugares certos. O merge no
mainficou comigo. Ligar o Bot Fight Mode, que é uma configuração de segurança, também. Excluir o post agendado, só depois de eu confirmar. - Ele também errou. Achou que a edição do post agendado tinha removido a prévia do link e só percebeu o contrário ao conferir a lista. Em outro momento, disse que não conseguia agendar o post, e fui eu que lembrei que o LinkedIn estava aberto no navegador.
- Ele não inventou o que não sabia. Quando a medição do CLS da home deu zero, a recomendação foi não mexer, e não “otimizar por garantia”.
O que fica para mim é o mesmo que já vale para trabalhar com pessoas: verifique o resultado, não a intenção. A diferença é que, com um agente, dá para pedir essa verificação o tempo todo.
Escrevi mais sobre como começar a trabalhar com IA em Do Medo à Maestria.
Checklist para quem tem um site pequeno
- Compare pelo menos duas fontes de dados antes de confiar em um número.
- Olhe o engajamento, não só os usuários. 3 segundos não é leitura.
- Separe robô de gente na borda, não no relatório.
- Veja os Core Web Vitals de usuários reais antes de otimizar qualquer coisa.
- Toda imagem precisa de
width/height(ouaspect-ratio) e de um formato e tamanho adequados. - Não otimize o que você não consegue reproduzir.
- Meça a distribuição com o mesmo cuidado que mede o site.
Até aqui
O número grande era fácil: 91 usuários. O número verdadeiro deu trabalho: algo como 5 leitores por dia. Mas é só com ele que dá para tomar alguma decisão.
Agora estão rodando dois experimentos: o Bot Fight Mode barrando robôs na borda e a mudança no jeito de divulgar os artigos no LinkedIn. Na parte 2 eu conto o que aconteceu com os números, inclusive se as hipóteses estiverem erradas.
E você? Já olhou quanto do tráfego do seu site é robô? Vamos conversar nos comentários! 🚀